Axelera AI 發表 Titania 架構,推出採 LPDDR6 的資料中心 AI 推論晶片

Axelera AI 公布小晶片(chiplet)設計的 Titania 架構,採用 LPDDR6 取代 HBM,主打以更低的耗電量在現有資料中心執行 AI 推論。
- Titania 是 Axelera AI 的第三代晶片架構,採小晶片設計並搭載可自訂程式化的 RISC-V 核心。
- 官方宣稱每瓦效能最高提升達 7 倍,TCO 比目前頂級資料中心伺服器優異最多達 20 倍。
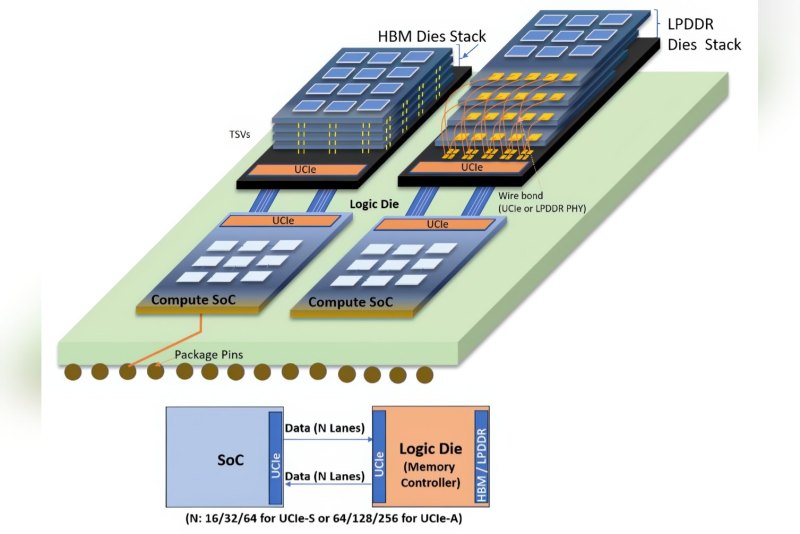
- 每個封裝支援 128 GB LPDDR6 記憶體,擺脫對供應短缺之 HBM 的依賴。
- Titania 預計於 2027 年第 3 季投產,目前已接獲超過 3 億美元的採購意向訂單。
文章目录
Titania 鎖定大規模 AI 推論需求
Axelera AI 近日公布旗下第三代晶片架構 Titania 的技術細節,該架構採小晶片設計,目標是在現有資料中心的供電與散熱限制下,提供高效能 AI 推論運算。相較之下,目前最高密度的 GPU 系統通常需要超過 100 kW 的水冷散熱機架支援。
每個系統級封裝(SiP)包含兩顆 Titania 小晶片。該封裝將提供多種形態,從標準 PCIe 介面卡到遵循 OCP 標準、整合 8 個 OAM 模組並透過 scale-up 網路互連的 UBB 基板。OEM 合作夥伴將推出採用氣冷或水冷架構的推論伺服器。據官方表示,Titania 目前已取得超過 3 億美元的採購意向承諾。
原廠設定的目標為每瓦效能最高達 7 倍、整體持有成本(TCO)最多改善 20 倍。不過這些數據均為製造商自行公布,尚未經過第三方獨立驗證。
D-IMC 架構與 LPDDR6 記憶體
Titania 延續了 Metis 與 Europa 的數位記憶體內運算(D-IMC)架構。新一代架構新增了浮點運算支援、納入更多小型核心,並具備更優異的資料調度機制。軟體層面則透過 Voyager 工具套件運作,原生支援張量、專家(expert)與管線平行處理(pipeline parallelism),同時支援投機解碼(speculative decoding)以及 KV cache 卸載功能。
Titania 捨棄 HBM,轉而採用成本更低且供應更充裕的 LPDDR6,每個封裝容量達 128 GB,同時擁有更低的功耗。原廠主張在稀疏混合專家模型(MoE)中,記憶體容量與利用率遠比峰值頻寬更為關鍵。這種做法同時避開了 HBM 的供應短缺風險以及複雜的先進封裝製程要求。
AX8 參考伺服器與推出時程
AX8 參考伺服器搭載 8 個 SiP,採用 4U 氣冷機箱設計。該配置在 FP8 精度下可提供 20 PFLOPS 算力、1 TB 記憶體與 19.6 TB/s 頻寬,典型功耗約 5 - 6 kW。單台伺服器即可容納 1.6 兆(trillion)參數的 FP4 模型,並保有足夠的 KV cache 預留空間。在 15 kW 機架上可運行兩台伺服器,而在 30 kW 氣冷機架上則可容納五台伺服器。
Titania PCIe 介面卡專為直接替代搭載 4 顆 Europa 晶片的 Axelera Server 250p 全高全長(FHFL)卡而設計,讓現有模型無需重新移植即可直接轉移。此外,該晶片支援 8K 解碼與 4K 編碼(支援 H.265 與 AV1),能有效減輕伺服器 CPU 在處理影片時的負擔。Titania 預計於 2027 年第 3 季進入量產,後續部署計畫將延續至 2028 年初。
歐洲本土研發設計
Titania 於歐洲本土研發,並獲得歐洲高效能運算共同承擔機構(EuroHPC Joint Undertaking)旗下 DARE 計畫的支持。Axelera AI 將於 11 月 15 日至 19 日在芝加哥舉行的 SC26 大會(McCormick Place,展位 3251)上公開展示詳細技術規格。
採用 LPDDR6 取代 HBM 是一項值得關注的策略轉變,畢竟 HBM 產能目前正是眾多 AI 晶片廠的關鍵瓶頸。然而,7 倍與 20 倍的數據目前僅屬原廠設定的目標,產品更要等到 2027 年才會正式投產。在與現行 GPU 進行客觀對比之前,建議讀者先靜候第三方獨立實測數據出爐,特別是執行大型模型時的實際頻寬表現。
資料來源:TechPowerUp
审核人: Hero Association