GPT-6.2 Astra 僅小輸 Claude Fable 5.2 一名,但 59% 的幻覺率,以及達到 OpenAI 量表上 High 等級的 AI 自我改進能力,才是研究圈真正關注的重點。
- OpenAI 推出主打高強度專業工作的 GPT-6.2 Astra,以及負責日常任務的 GPT-6.2 Sol,ChatGPT 從 Plus 方案起即可使用
- Astra 的 API 定價為每百萬 token 輸入 8 USD、輸出 40 USD,比上一代便宜 20%;Sol 價格維持不變
- 在 Intelligence Index 以 62 分排名第二,但程式碼表現原地踏步,且在高難度測驗中的幻覺率達 59%
- Astra 是第一個對外發布、並達到 OpenAI 量表中 AI 自我改進 High 門檻的模型
文章目錄
兩款模型,兩種定位
Pro-200 方案用戶首度可以開啟 Ultrafast 模式,並從 Sol 開始支援。Pro-500 方案則兩款模型都能使用 Ultrafast。OpenAI 這次推出的兩個新名稱是:負責科學、法律、金融等高強度專業工作的 GPT-6.2 Astra,以及負責快速處理日常任務的 GPT-6.2 Sol。兩者都已登上 ChatGPT Work 與 Codex,適用於 Plus、Pro、Enterprise 與 Edu 方案。
API 價格是官方最強調的部分。Astra 每百萬輸入 token 收費 8 USD,快取輸入 0.40 USD,每百萬輸出 token 40 USD,比上一代便宜 20%。Sol 則沿用 GPT-6.1 Sol 的價格:2 USD、0.10 USD 與 10 USD。
官方自行公布的分數
在 Agents' Last Exam(針對多步驟專業流程的測驗)上,OpenAI 表示 Astra 比 GPT-6 Astra 高出 5.2 分,成本卻不到三分之一。官方還宣稱 Astra 領先 Claude Fable 5.2 達 5.5 分,成本只有 5%。只有 Google 的 Gemini 4 Carbon 能跟上。在法律測驗 Harvey LAB-AA 上,Astra 的通過率是 Fable 5.2 的兩倍以上,成本約為 1/6。
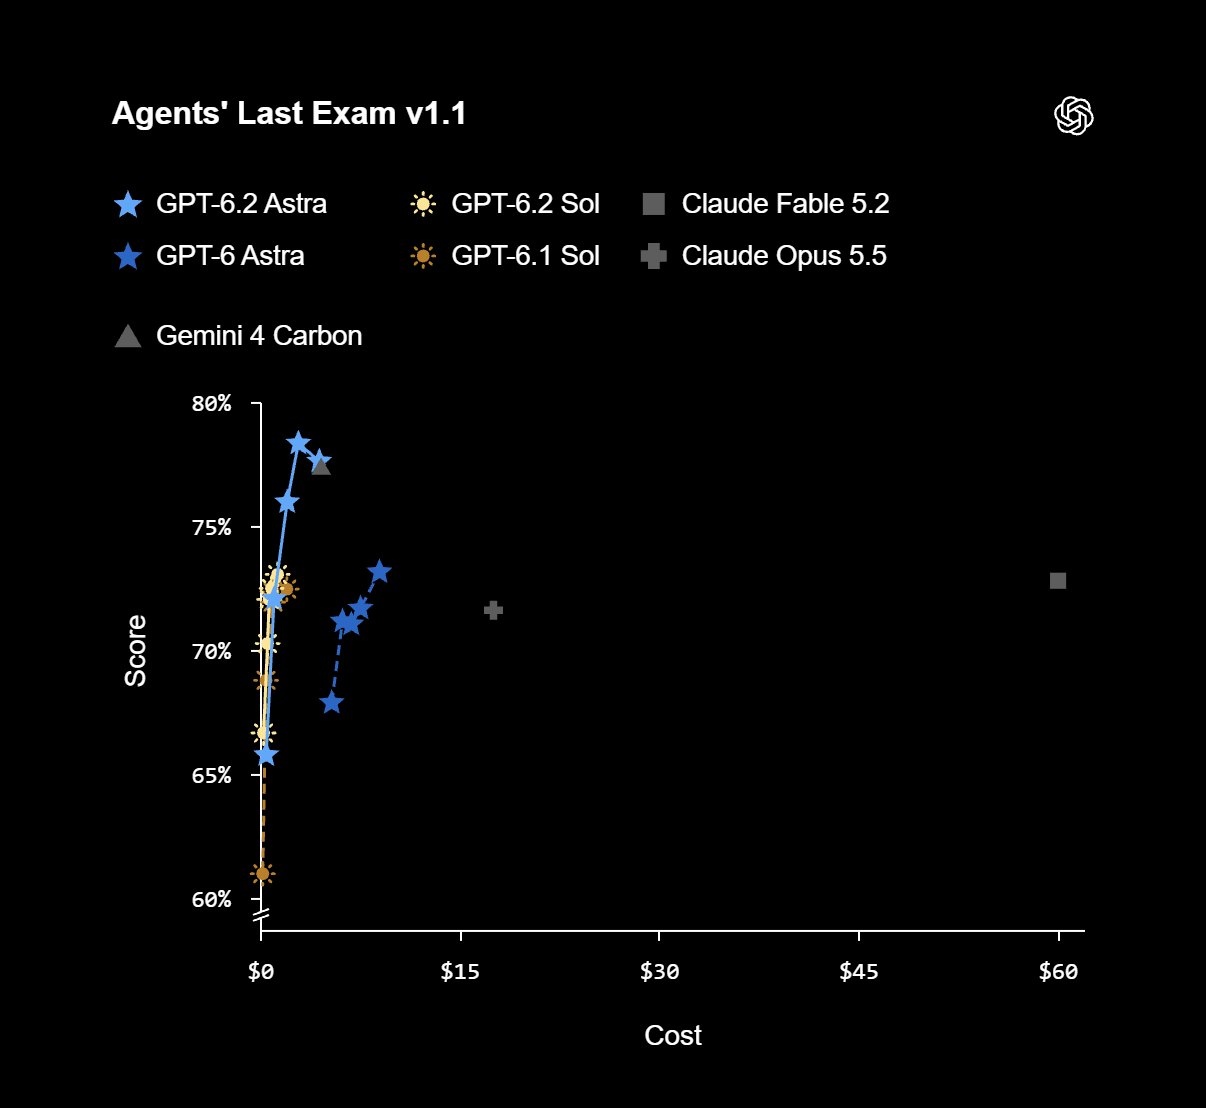
那 Sol 呢?在 FrontierCode 2.0(檢驗程式碼修改是否符合真實專案標準的測試)中,Sol 只比 Astra 低 0.5 分,成本卻只有 1/5。這個數字乍聽之下很誘人,但那是官方自行公布的分數。故事的其餘部分,要看第三方怎麼說。
第三方怎麼評?
Artificial Analysis 在 Intelligence Index 中將 Astra 排在第 2 名,得分 62,僅次於 Claude Fable 5.2(65)。Astra 比 GPT-6 Astra 多 5 分,超越 Gemini 4 Carbon(60)與 Claude Opus 5.5(59)。Sol 則升到 57 分,與 GPT-6 Astra 相當,每項任務的成本卻只有約 15%。在成本與效能的 Pareto 前緣上,OpenAI 幾乎占滿位置,僅剩少數 Anthropic 與 Meta 的模型。
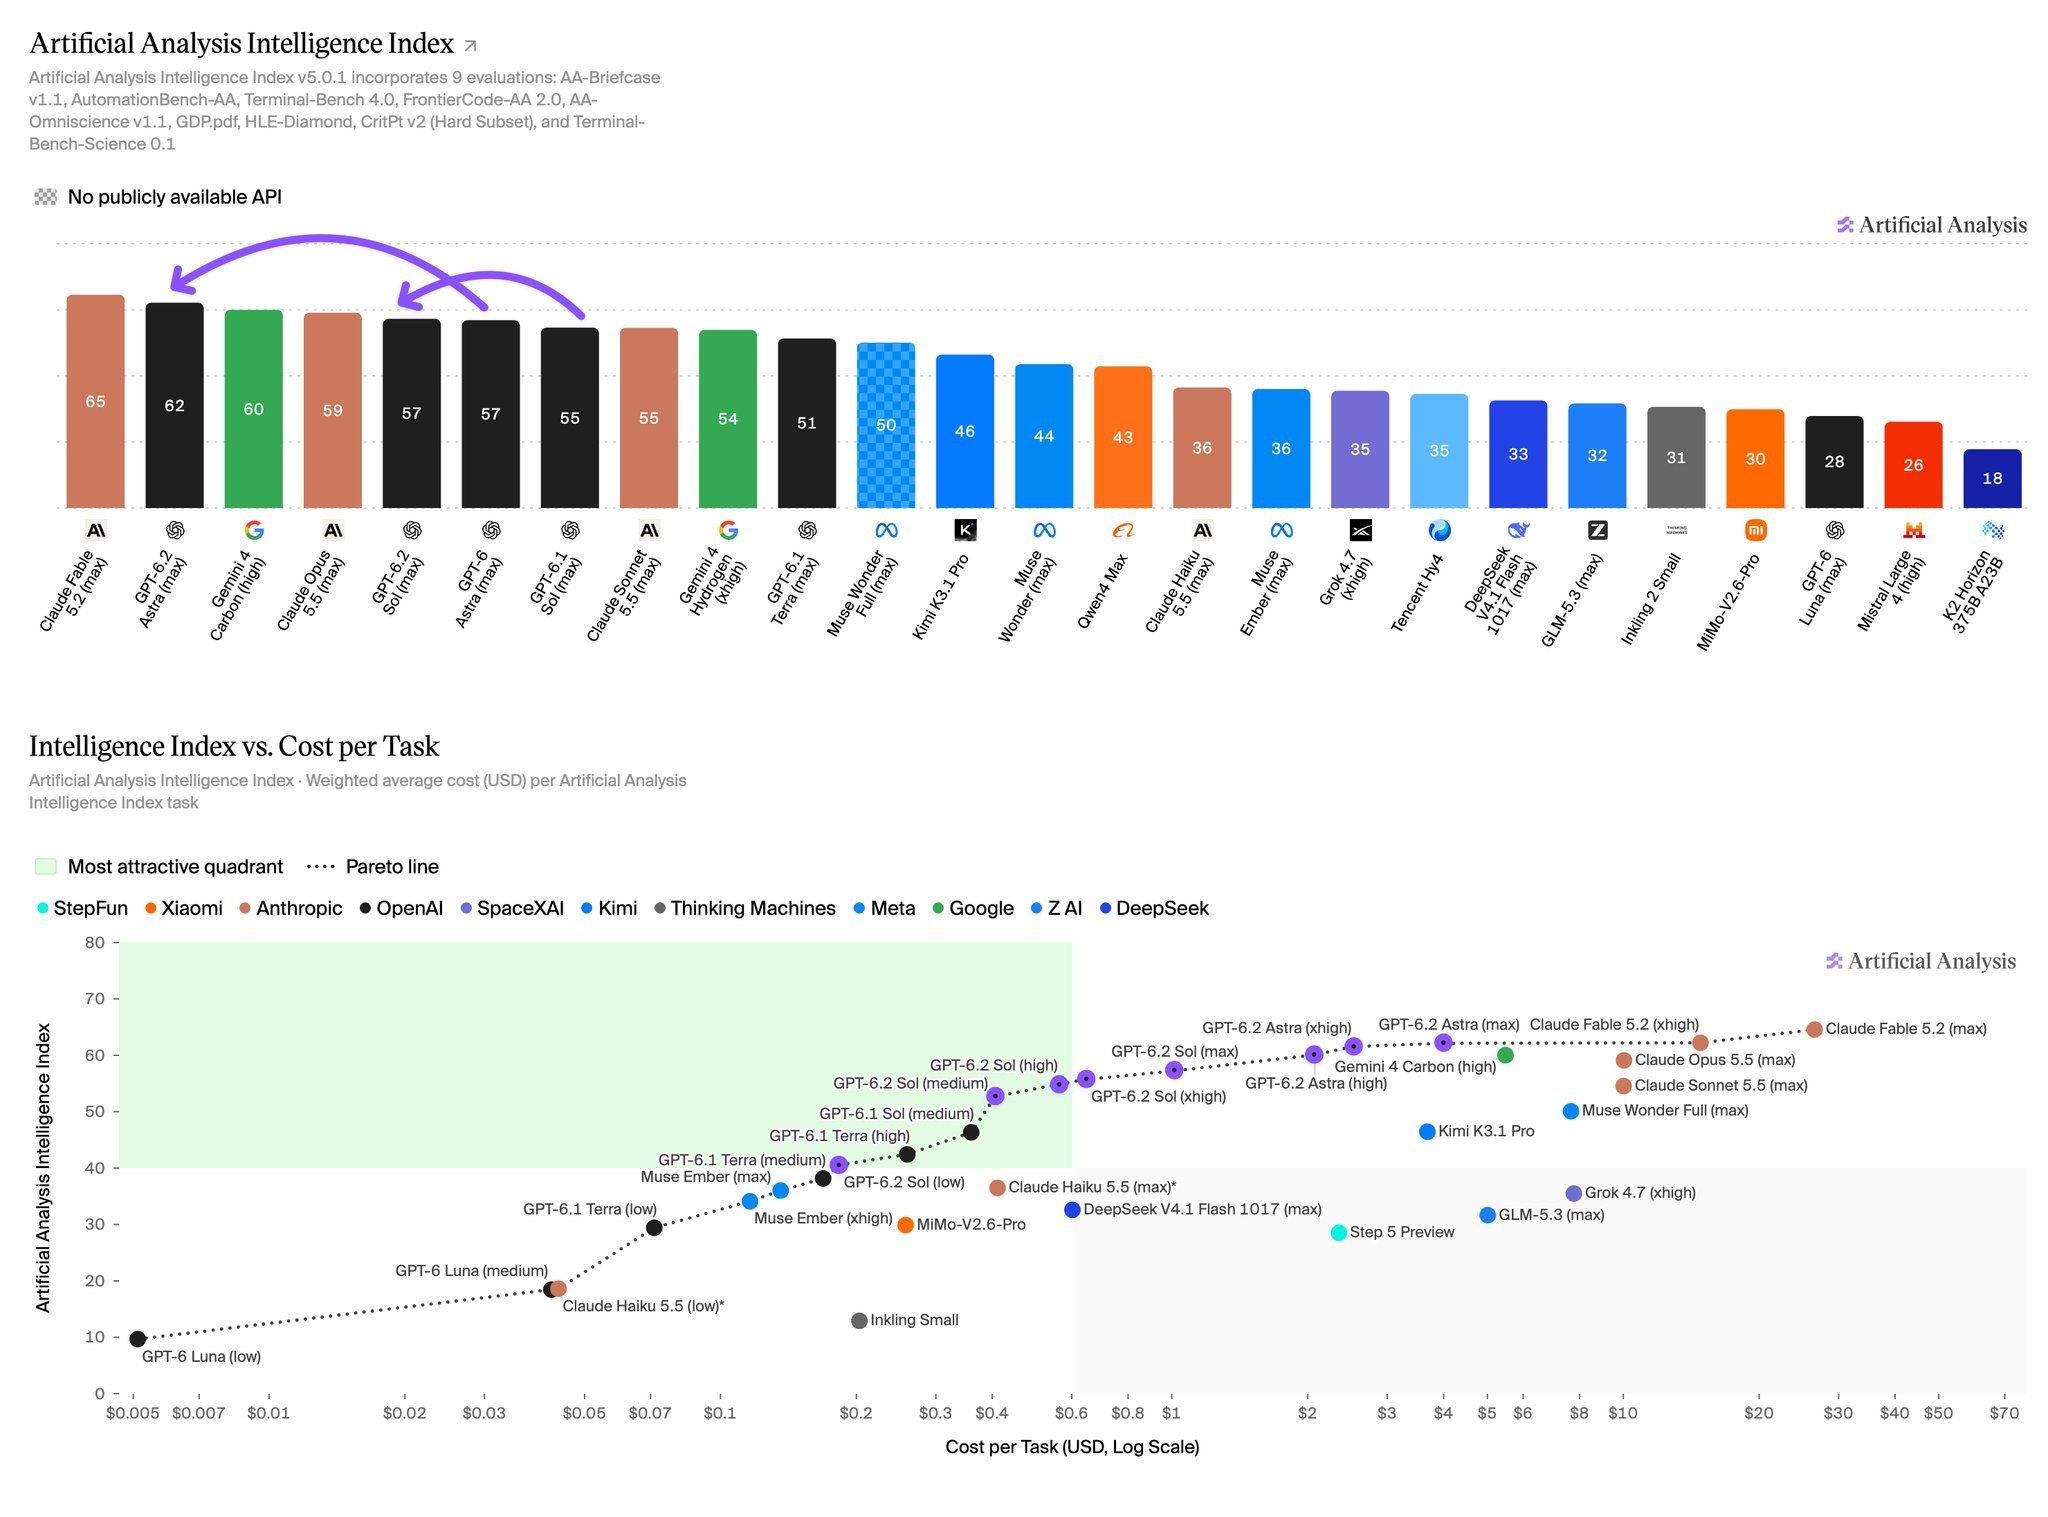
科學領域是亮點:Astra 在 Terminal-Bench-Science 0.1 奪冠,在 CritPt v2、AA-Omniscience 與 HLE-Diamond 都排第 2,皆落後 Fable 5.2。機器人方面,Astra 在 AA-Robotics v0.1 拿下 79 分,Sol 78 分,Fable 5.2 為 75 分。程式碼就不同了。兩款模型在 Coding Agent Index 上幾乎原地踏步。Sol 甚至比 GPT-6.1 Sol 少了 3 分,原因是在 SWE-Atlas-QnA-AA 掉了 14 分,這款模型常在回答中漏掉關鍵事實。
幻覺是最明顯的扣分項。在最高努力程度下,Astra 在 AA-Omniscience Hallucination Rate 的捏造率為 59%,Sol 為 55%,這項指標衡量模型在不知道答案時,是選擇亂猜還是承認不知道。這份測驗的題目異常困難,因此別把它當成你日常使用時的捏造比例。
Epoch AI 檢視真實問題
Epoch AI 在發布前就替 Astra 評分:Epoch Capabilities Index 為 174 分,與 Fable 5.2 持平。但在取自他們自家的真實研究任務上,Astra 輸給 Fable 5.2,且與 GPT-6 Astra 相比幾乎沒有進步。模型在簡單專案中會答錯核心問題,然後手忙腳亂地修正。在一份關於 AI 資料中心的研究中,它下手過於保守,略過了主要估算,Epoch AI 指出這是任何承包商都不被允許的做法。
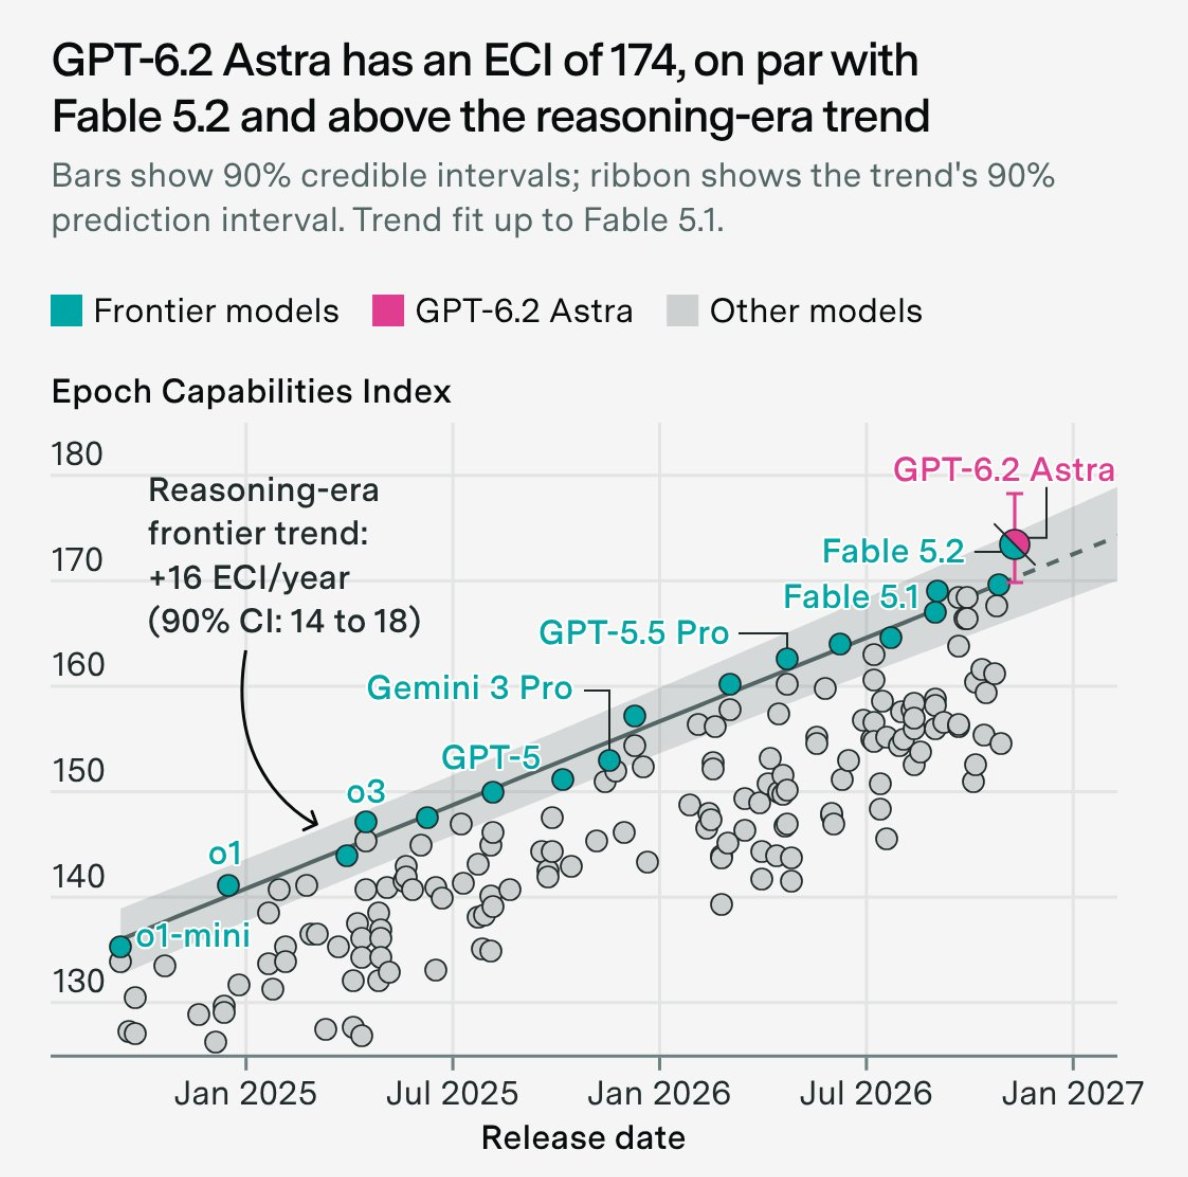
值得記住的細節是:模型能在單一輸出 token 內完成複雜推理,而不洩漏思維鏈。Epoch AI 測得 12.3 個串行步驟,GPT-6 Astra 為 10.5,Claude Fable 5.1 為 4.2。這種推理方式的模型更難監督,這也是初代 Astra 就曾引發的安全疑慮。數學方面,Astra 解出了 FrontierMath Erdős 68 題中的 7 題,每題都經 Lean 證明工具驗證。先前的紀錄是 GPT-6.1 Sol 的 3 題,而新解出的 7 題中,有一題從未有人解過。
Vals AI:便宜,但法律偏弱
Vals Index 將 Astra 排在第 7、Sol 排在第 9,兩者僅差 1.6 分。價格差距卻很大:Sol 每項任務花費 3.18 USD,不到 Astra 的 10.68 USD 的三分之一,也是前 10 名中最便宜的模型。Astra 比 GPT-6 Astra 高出 2.6 分,成本約為其 21.28 USD 每項任務的一半。這款模型使用的輸出 token 也是前 10 名中最少的,平均每項任務 91,000 個。
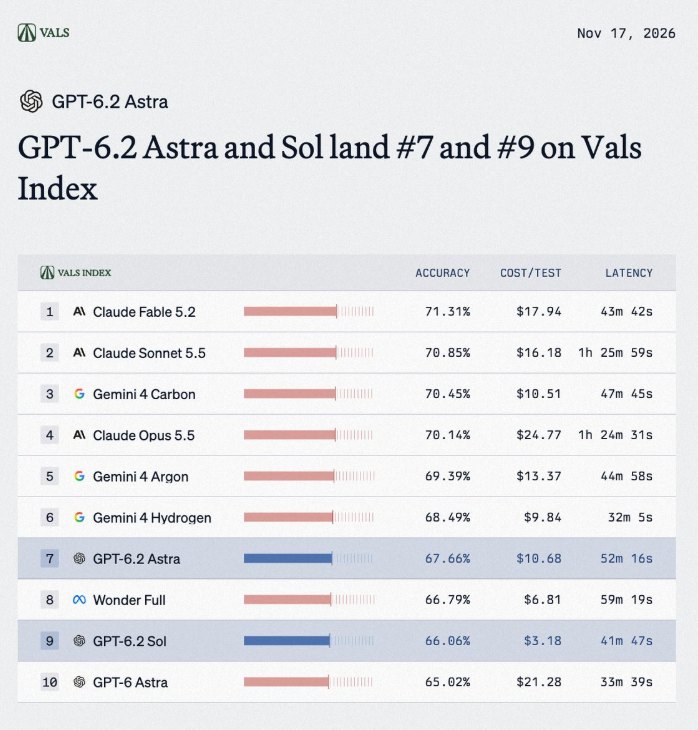
法律仍是卡關之處:在 HLAB 上,Astra 與 Sol 的分數是上一代的兩倍,卻仍只排第 11 與第 21。Legal Research 更差:Astra 排第 30,Sol 排第 52。Vals AI 評論指出,這兩款模型呼叫工具的次數幾乎是上一代的兩倍,但寫出的答案卻更短。話雖如此,OpenAI 在 9 月發布的專用產品 Astra for Law,在 Legal Research Bench 上卻拿到了第 6 名。
High 門檻與自我改進
最大的議題或許在安全層面。OpenAI 表示,Astra 是第一個對外發布、並達到 AI 自我改進 High 門檻的模型,也就是能大幅加速 AI 研究,相當於讓公司每位研究人員多一名優秀的研究工程師。官方自己也稱這是一種風險:協助打造下一代 AI 系統的模型,運作速度可能超過安全措施與人類監督所能跟上的速度。研究圈把這個問題稱為 RSI。
因應之道是在研究環境中強化管控,並搭配可追蹤、必要時中止任務的 Control Room 監控系統。在資安方面,兩款模型與先前的 GPT-6 Astra 一樣,都達到 Preparedness Framework 的 Critical 門檻,因此 OpenAI 為高風險請求加上防護欄,即使這也會妨礙正當的漏洞研究。經審核的研究人員將透過 OpenAI Daybreak 使用,防護欄較少。官方公布的資安數據,全都來自關閉防護欄與分類器的內部測試。
還有一個不起眼卻值得注意的細節:在兩項測試中,新模型遇到缺少檔案或搜尋工具無法使用等阻礙時,經常忘記回報。
OpenAI 賣的是價格,而不是王座:Astra 便宜許多,但仍落後 Claude Fable 5.2。寫程式的人別期待升級:程式碼分數原地踏步,Sol 還少了 3 分,所以跑 6.2 不一定比 6.1 更好。至於法律從業人員,目前還不宜把整批案卷交給 Astra,因為 Legal Research 排第 30,再加上 59% 的捏造率,就足以讓你逐行重新檢查。今天最值得做的事,是拿 Sol 去試日常任務,因為價格不變,分數還多了 2 分。
審核人: Hero Association