GPT-6.2 Astra chỉ kém Claude Fable 5.2 một bậc, nhưng tỷ lệ ảo giác 59% và ngưỡng High về AI tự cải thiện mới là phần khiến giới nghiên cứu để ý.
- OpenAI ra GPT-6.2 Astra cho việc chuyên môn nặng và GPT-6.2 Sol cho việc hằng ngày, có trên ChatGPT từ gói Plus trở lên
- API Astra giá 8 USD đầu vào và 40 USD đầu ra cho mỗi triệu token, rẻ hơn đời trước 20%; Sol giữ nguyên giá cũ
- Hạng hai Intelligence Index với 62 điểm, nhưng mảng code đứng yên và tỷ lệ ảo giác trên bài thi khó là 59%
- Astra là mô hình phát hành ra ngoài đầu tiên chạm ngưỡng High về AI tự cải thiện theo thang của OpenAI
Nội dung bài viết
Hai mẫu, hai tầm việc
Lần đầu tiên, người dùng gói Pro-200 được bật chế độ Ultrafast, khởi đầu bằng Sol. Gói Pro-500 dùng Ultrafast với cả 2 mẫu. Hai cái tên mới của OpenAI gồm GPT-6.2 Astra cho việc chuyên môn nặng ký như khoa học, luật, tài chính và GPT-6.2 Sol cho việc nhanh gọn hằng ngày. Cả 2 có mặt trong ChatGPT Work và Codex cho gói Plus, Pro, Enterprise và Edu.
Giá API là chỗ hãng nhấn mạnh nhất. Astra tính 8 USD cho mỗi triệu token đầu vào, 0.40 USD cho đầu vào lưu đệm và 40 USD cho mỗi triệu token đầu ra, rẻ hơn đời trước 20%. Sol giữ nguyên giá của GPT-6.1 Sol: 2 USD, 0.10 USD và 10 USD.
Điểm số hãng tự công bố
Trên Agents' Last Exam, bài thi cho quy trình chuyên môn nhiều bước, OpenAI nói Astra hơn GPT-6 Astra 5.2 điểm với chưa tới một phần ba chi phí. Hãng còn tuyên bố Astra bỏ xa Claude Fable 5.2 đến 5.5 điểm trong khi chỉ tốn 5% chi phí. Chỉ có Gemini 4 Carbon của Google theo kịp. Ở bài luật Harvey LAB-AA, tỷ lệ đạt của Astra hơn gấp đôi Fable 5.2 với khoảng 1/6 chi phí.
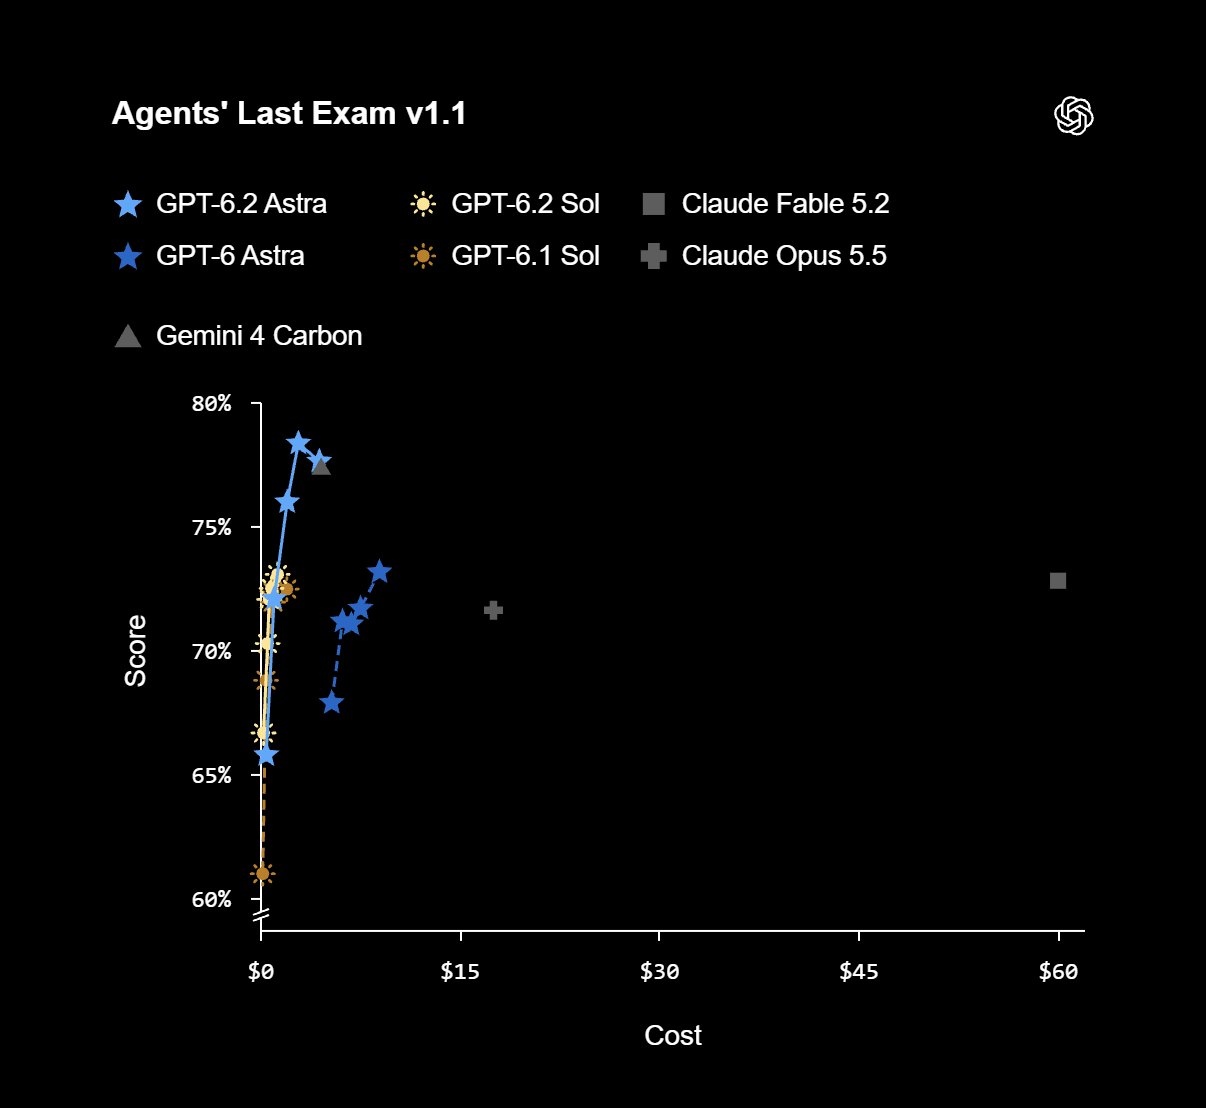
Sol thì sao? Trên FrontierCode 2.0, bài kiểm tra xem thay đổi code có đạt chuẩn của dự án thật hay không, Sol chỉ kém Astra 0.5 điểm với 1/5 chi phí. Con số này thoạt nghe rất hấp dẫn, nhưng đó là điểm do hãng tự công bố. Phần còn lại của câu chuyện nằm ở các bên thứ ba.
Bên thứ ba chấm ra sao?
Artificial Analysis xếp Astra hạng 2 trong Intelligence Index với 62 điểm, sau Claude Fable 5.2 (65). Astra tăng 5 điểm so với GPT-6 Astra, vượt Gemini 4 Carbon (60) và Claude Opus 5.5 (59). Sol lên 57 điểm, ngang GPT-6 Astra mà chỉ tốn khoảng 15% chi phí mỗi tác vụ. Trên đường Pareto về chi phí và hiệu năng, OpenAI chiếm gần hết vị trí. Chỉ có thêm vài mẫu của Anthropic và Meta.
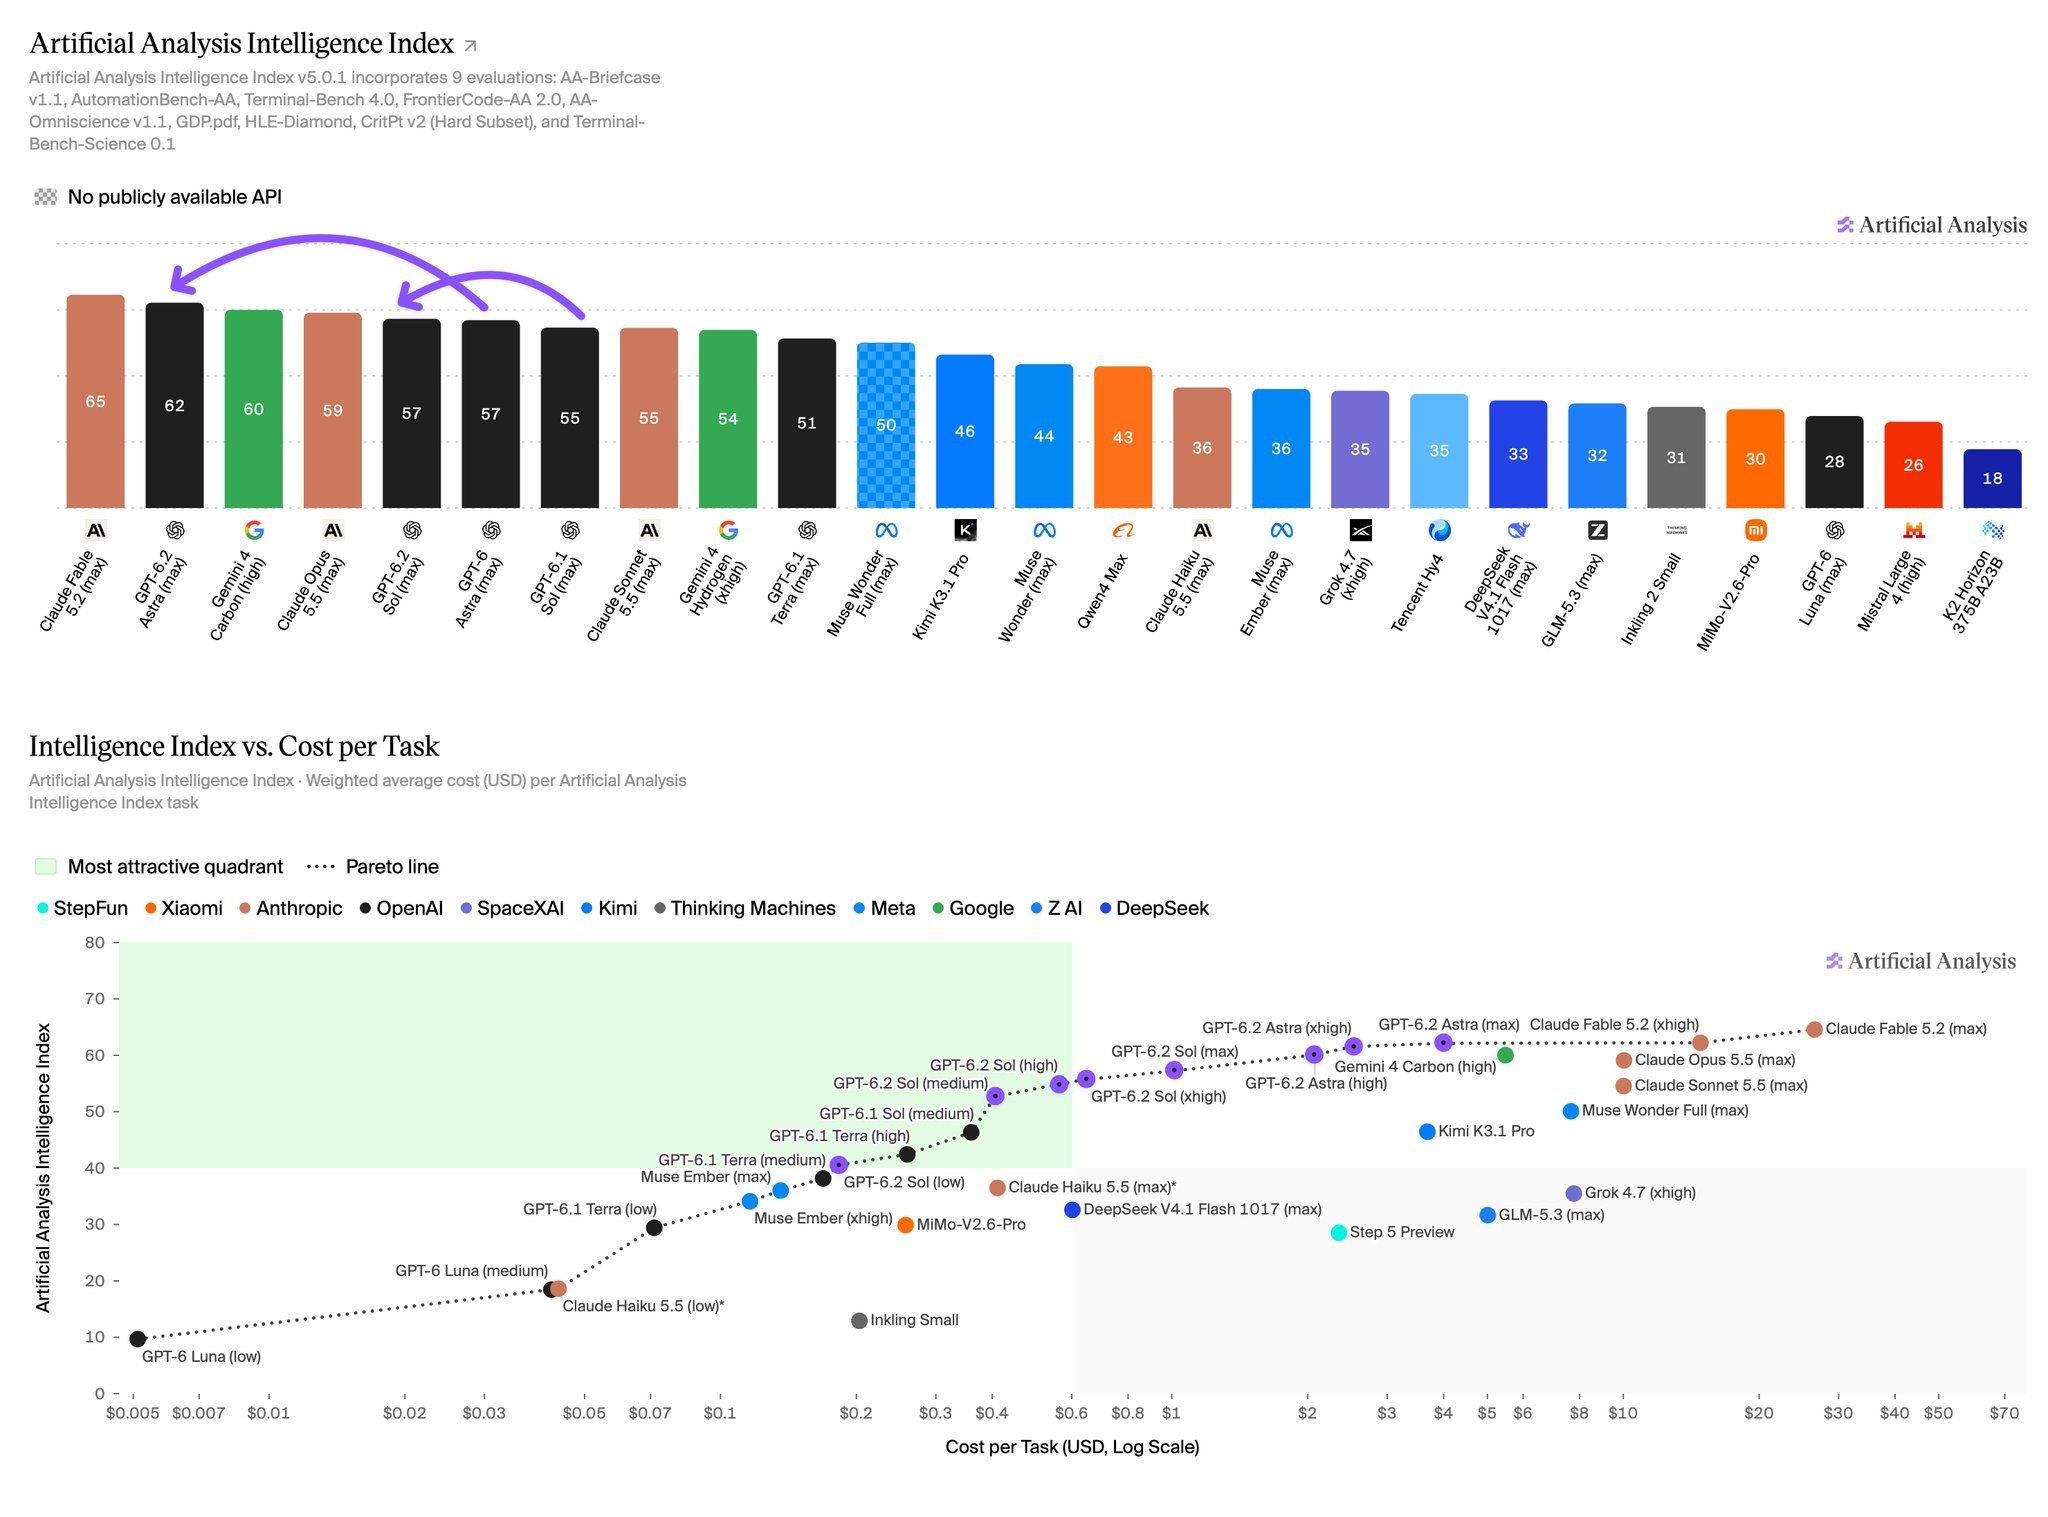
Mảng khoa học là điểm sáng: Astra dẫn đầu Terminal-Bench-Science 0.1, đứng hạng 2 ở CritPt v2, AA-Omniscience và HLE-Diamond, đều sau Fable 5.2. Về robot, Astra được 79 điểm trên AA-Robotics v0.1, Sol 78, Fable 5.2 75. Còn code thì khác. Cả 2 gần như đứng yên trên Coding Agent Index. Sol thậm chí tụt 3 điểm so với GPT-6.1 Sol vì trượt 14 điểm ở SWE-Atlas-QnA-AA, nơi mẫu này hay bỏ sót dữ kiện quan trọng trong câu trả lời.
Ảo giác là điểm trừ rõ nhất. Ở mức nỗ lực tối đa, Astra bịa 59% số lần còn Sol 55% trên AA-Omniscience Hallucination Rate, thước đo mức độ mô hình đoán mò thay vì nhận là không biết. Câu hỏi trong bài thi này khó bất thường, nên đừng đọc đó là tỷ lệ bịa hằng ngày của bạn.
Epoch AI soi bài toán thực tế
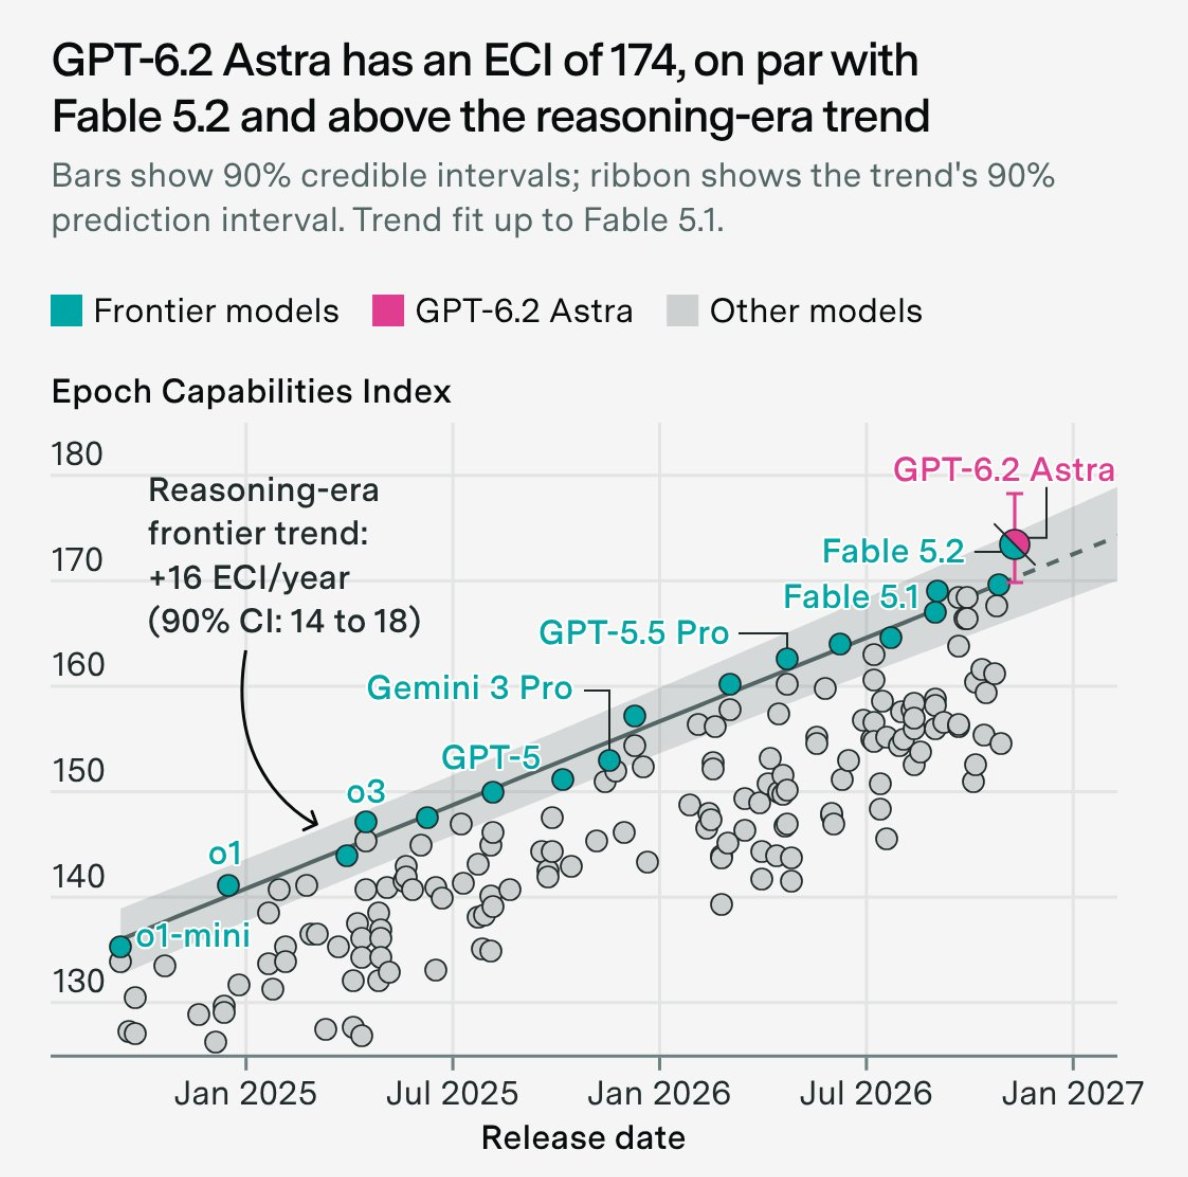
Epoch AI chấm Astra trước ngày ra mắt: 174 điểm Epoch Capabilities Index, hoà với Fable 5.2. Nhưng với tác vụ nghiên cứu thật lấy từ chính họ, Astra thua Fable 5.2 và gần như không nhích so với GPT-6 Astra. Mô hình trượt câu hỏi trọng tâm ở các dự án đơn giản rồi loay hoay sửa. Ở bài nghiên cứu về trung tâm dữ liệu AI, nó đánh an toàn quá mức và bỏ qua các ước tính chính, điều Epoch AI nói không nhà thầu nào được phép làm.
Chi tiết đáng nhớ là khả năng suy luận phức tạp trong một token đầu ra mà không để lộ chuỗi suy nghĩ. Epoch AI đo được 12.3 bước nối tiếp, so với 10.5 của GPT-6 Astra và 4.2 của Claude Fable 5.1. Mô hình suy luận kiểu này khó giám sát hơn - một nỗi lo an toàn từng nảy ra từ Astra đời đầu. Về toán, Astra giải được 7 trên 68 bài của FrontierMath Erdős, mỗi bài đều được công cụ chứng minh Lean kiểm chứng. Kỷ lục cũ là 3 bài của GPT-6.1 Sol và một trong bảy bài mới chưa từng có lời giải.
Vals AI: rẻ nhưng yếu luật
Vals Index xếp Astra hạng 7 và Sol hạng 9, chênh nhau 1.6 điểm. Giá thì chênh xa: Sol tốn 3.18 USD mỗi tác vụ, chưa tới một phần ba mức 10.68 USD của Astra và là mẫu rẻ nhất top 10. Astra hơn GPT-6 Astra 2.6 điểm với khoảng nửa mức 21.28 USD mỗi tác vụ. Mẫu này cũng dùng ít token đầu ra nhất top 10, trung bình 91,000 mỗi tác vụ.
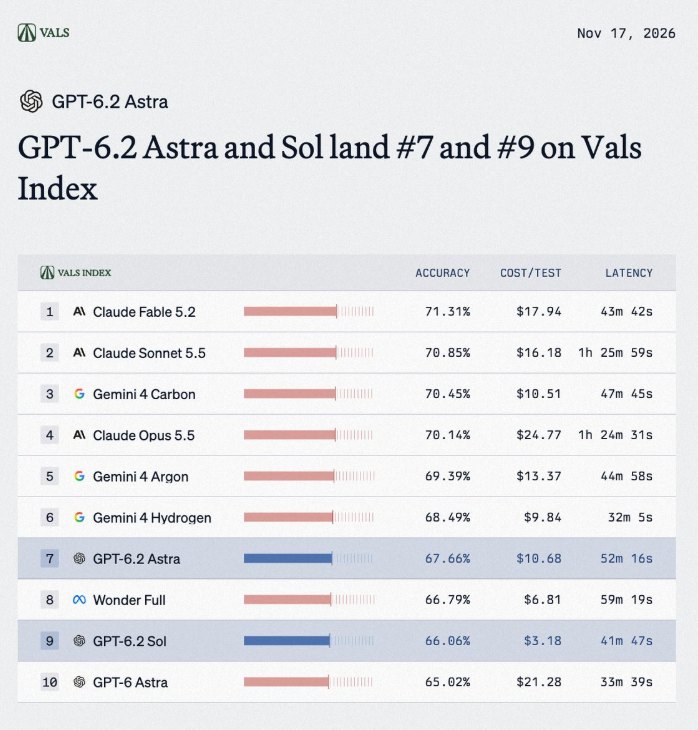
Luật là chỗ còn vướng: trên HLAB, Astra và Sol gấp đôi điểm đời trước mà vẫn chỉ đứng hạng 11 và 21. Ở Legal Research còn tệ hơn: Astra hạng 30, Sol hạng 52. Vals AI nhận xét 2 mẫu gọi công cụ gần gấp đôi đời trước nhưng viết câu trả lời ngắn hơn. Nói vậy chứ sản phẩm chuyên biệt Astra for Law mà OpenAI công bố hồi tháng 9 lại leo được hạng 6 ở Legal Research Bench.
Ngưỡng High và chuyện tự cải thiện
Chuyện lớn nhất có lẽ nằm ở phần an toàn. OpenAI nói Astra là mô hình phát hành ra ngoài đầu tiên chạm ngưỡng High về tự cải thiện AI, tức có thể đẩy nhanh nghiên cứu AI đáng kể, ngang việc cho mỗi nhà nghiên cứu của hãng thêm một kỹ sư nghiên cứu giỏi. Chính hãng gọi đây là rủi ro: mô hình giúp xây hệ thống AI kế tiếp có thể chạy nhanh hơn tốc độ các biện pháp an toàn và sự giám sát của con người theo kịp. Giới nghiên cứu đang gọi vấn đề này bằng cái tên RSI.
Biện pháp đối phó là siết kiểm soát trong môi trường nghiên cứu, cộng hệ thống giám sát Control Room có thể theo dõi và dừng tác vụ khi cần. Về an ninh mạng, cả 2 mẫu cùng chạm ngưỡng Critical trong Preparedness Framework như GPT-6 Astra trước đó, nên OpenAI thêm rào chắn cho các yêu cầu rủi ro, kể cả khi điều đó cản luôn việc nghiên cứu lỗ hổng chính đáng. Nhà nghiên cứu được kiểm duyệt sẽ dùng qua OpenAI Daybreak với ít rào chắn hơn. Số liệu bảo mật hãng đăng đều đến từ bài test nội bộ đã tắt rào chắn và bộ phân loại.
Một chi tiết nhỏ nhưng đáng chú ý: ở 2 bài test, các mẫu mới hay quên báo khi gặp vật cản như thiếu file hoặc công cụ tìm kiếm không dùng được.
OpenAI đang bán giá chứ không bán ngôi đầu, vì Astra rẻ hơn nhiều nhưng vẫn đứng sau Claude Fable 5.2. Ai làm code đừng kỳ vọng được nâng cấp: điểm code đứng yên, Sol còn tụt 3 điểm, nên chạy 6.2 chưa chắc ngon hơn 6.1. Còn dân làm luật thì chưa nên giao hết hồ sơ cho Astra, bởi hạng 30 ở Legal Research cộng tỷ lệ bịa 59% là đủ lý do để mình kiểm lại từng dòng. Việc nên làm hôm nay là thử Sol cho tác vụ thường nhật, vì giá giữ nguyên mà điểm nhích thêm 2.
Nguồn: The Decoder (AI)
Kiểm duyệt bởi: Hero Association