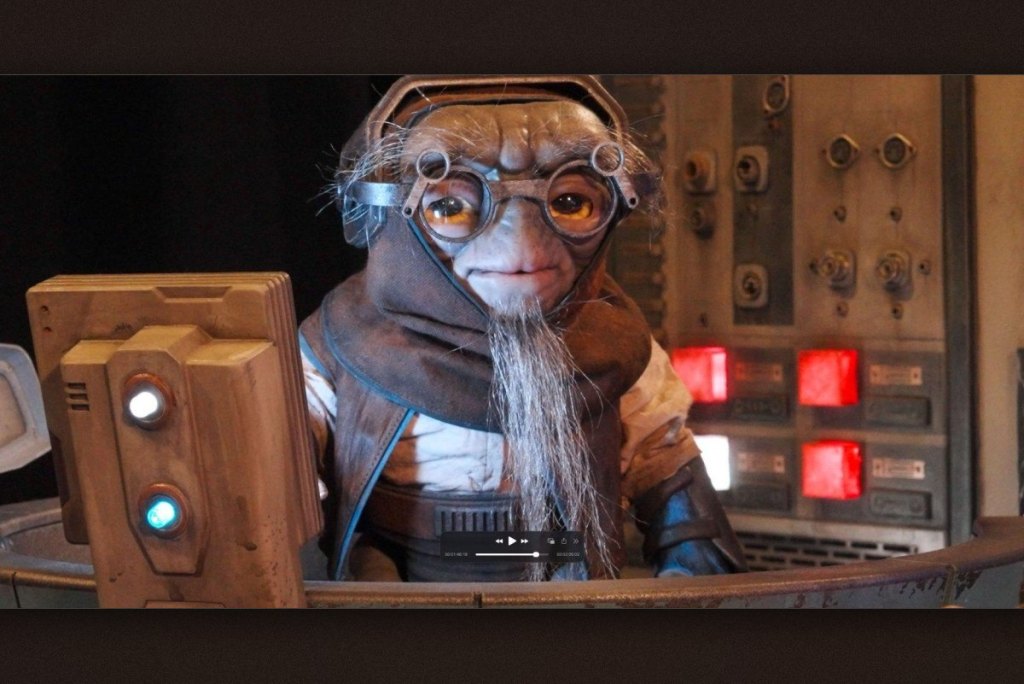
Có 3 robot Anzellan tự nhìn, nghe và phản ứng với khách qua AWS nhưng mọi cử động và câu thoại đều do đội Imagineering của Disney viết sẵn từ trước.
- Walt Disney Imagineering R&D giới thiệu 3 mẫu Audio-Animatronic thử nghiệm: Vilo Vele, Kado Bre'a và Jibu Bre'a
- Camera và micro giấu kín thu hình ảnh, giọng nói của khách để các mô hình AI chạy trên đám mây AWS xử lý
- Mọi cử động và lời thoại đều do Imagineer viết sẵn, AI chỉ chọn và kích hoạt đúng lúc
- Ra mắt công chúng tại hội nghị AWS re:Invent ở Las Vegas, sau này có thể vào Star Wars: Galaxy's Edge
Nội dung bài viết
3 robot Anzellan lần đầu ra mắt
Robot ở các công viên Disney dù đã tinh vi và giống thật đến đâu thì phần lớn vẫn chạy theo chuyển động lập trình sẵn, hoặc có một người điều khiển khuất tầm mắt để hành vi trông tự nhiên hơn. Điều đó có thể sớm thay đổi, vì Walt Disney Imagineering R&D vừa công bố 3 mẫu Audio-Animatronic thử nghiệm dùng đám mây AWS và khả năng AI của Amazon để phản ứng khác nhau với từng khách ngay trong lúc tương tác.
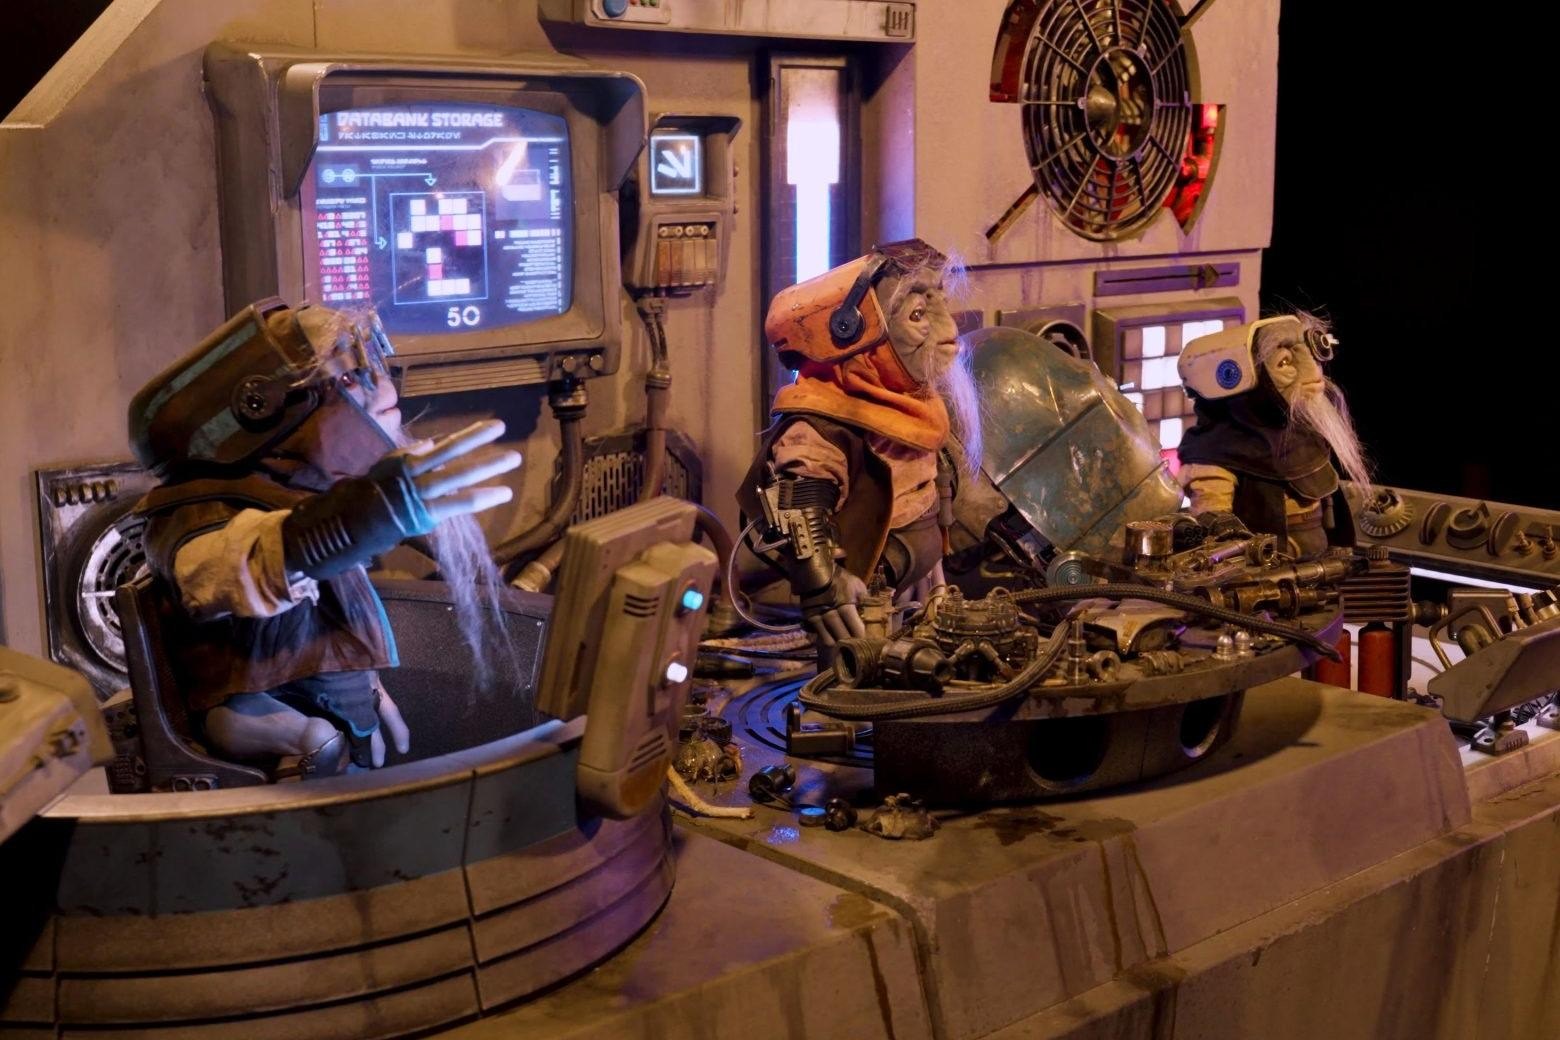
Các robot này có tên Vilo Vele, Kado Bre'a và Jibu Bre'a, dựa trên nhóm nhân vật người ngoài hành tinh Anzellan của Star Wars từng xuất hiện trong phim The Mandalorian and Grogu ra mắt hồi đầu năm nay. Mỗi con có một cá tính riêng, còn lần xuất hiện đầu tiên trước công chúng sẽ diễn ra tại Las Vegas, nơi khách dự hội nghị AWS re:Invent được trò chuyện với chúng. Về lâu dài, các nhân vật này cùng công nghệ phía sau có thể đi tiếp vào Star Wars: Galaxy's Edge và những điểm tham quan khác trong công viên Disney.
Cách hệ thống nhận biết khách
Khác với robot Olaf vừa ra mắt gần đây, vốn cần một người âm thầm dùng máy chơi game cầm tay Steam Deck để điều khiển, các Anzellan không có ai đứng sau giật dây. Mỗi robot được gắn camera và micro giấu kín để ghi lại cử động cũng như lời nói của khách, rồi dữ liệu đó được nhiều mô hình AI chạy trên máy chủ đám mây AWS xử lý.
Các mô hình này chia việc theo tốc độ cần thiết. Một "fast-decision model" lo những phản hồi tức thời, chẳng hạn nhanh chóng nhìn vào mắt khách để họ có cảm giác robot đang chú ý đến mình, còn các mô hình lớn hơn thì tính toán cho những lượt tương tác kéo dài hơn.
Lời thoại vẫn do con người viết
Dù vậy, cử động và lời đáp của Anzellan không phải do AI tự nghĩ ra tại chỗ. Mỗi động tác và mỗi câu thoại mà các mô hình chọn rồi kích hoạt đều đã được Imagineer của Disney viết sẵn, nhằm giữ hoạt ảnh đúng với từng nhân vật, kể cả những nét tính cách riêng của mỗi con.
Nói cách khác, AI ở đây giúp định hướng hành động của robot, còn chuyện nói gì và làm gì thì các Anzellan không bao giờ đi ra ngoài kịch bản.
Cách làm của Disney khá thực tế: để AI lo phần nhìn, nghe và chọn thời điểm phản ứng, còn nội dung vẫn nằm trong tay người viết, nên nhân vật khó lạc khỏi tính cách vốn có khi đứng trước đông khách. Vì vậy cụm "tương tác bằng AI" nên được hiểu là AI đóng vai người chọn cảnh chứ chưa phải diễn viên tự ứng biến và đó cũng là lý do hướng đi này có vẻ an toàn hơn cho một công viên giải trí. Với người dùng Việt Nam, đây trước hết là tín hiệu về cách các công viên lớn sẽ làm robot trong những năm tới, vì hiện chưa có thông tin nào cho biết khi nào công nghệ này xuất hiện ở các điểm tham quan thật sự. Nếu bạn định đi Disney thì chưa cần vì chuyện này mà đổi kế hoạch, hãy xem đây là thứ có thể gặp ở Galaxy's Edge sau này.
Nguồn: The Verge
Kiểm duyệt bởi: Hero Association