群聯表示,旗下內建 NPU 的 SSD 可將需傳輸的資料量減少 10 至 100 倍,因為硬碟會自行篩選資料,只把需要的結果回傳給伺服器。
- 群聯在芝加哥 SC26 展出配備專屬 NPU 與 64 GB 板載記憶體的企業級 SSD
- 此硬碟支援 PyTorch、vLLM、OpenVINO 與 llama.cpp,官方指出在適合的工作負載下,資料傳輸量可減少 10 至 100 倍
- NPU 效能以 DMIPS 而非 TOPS 計算,因此難以與其他 NPU 比較
- 控制器、介面、尺寸與記憶體類型尚未公布,產品仍處於試驗階段
文章目錄
會自行執行 AI 框架的 SSD
在芝加哥舉行的 Supercomputing 2026(SC26)上,群聯(Phison)展示了一款採用運算儲存(computational storage)概念的企業級 SSD,也就是硬碟不只負責存放資料,還能自行處理一部分運算工作。硬碟內部配有專屬 NPU,以及頻寬達 130 GB/s 的 64 GB 記憶體,因此 AI 框架可以直接在硬碟上執行,無須把資料搬到外部。支援的軟體包括 PyTorch、vLLM、OpenVINO 與 llama.cpp,都是 AI 開發者相當熟悉的工具。
群聯瞄準的優勢在於需要搬移的資料量。在一般系統中,要處理某個資料集,整個資料集都得經過伺服器;而在這種設計中,硬碟會在內部平行掃描並處理資料,再只回傳相關的結果。因此官方認為,傳輸的資料量可減少 10 至 100 倍,不過這個數字僅適用於合適的工作負載,並非所有情況都能達到。
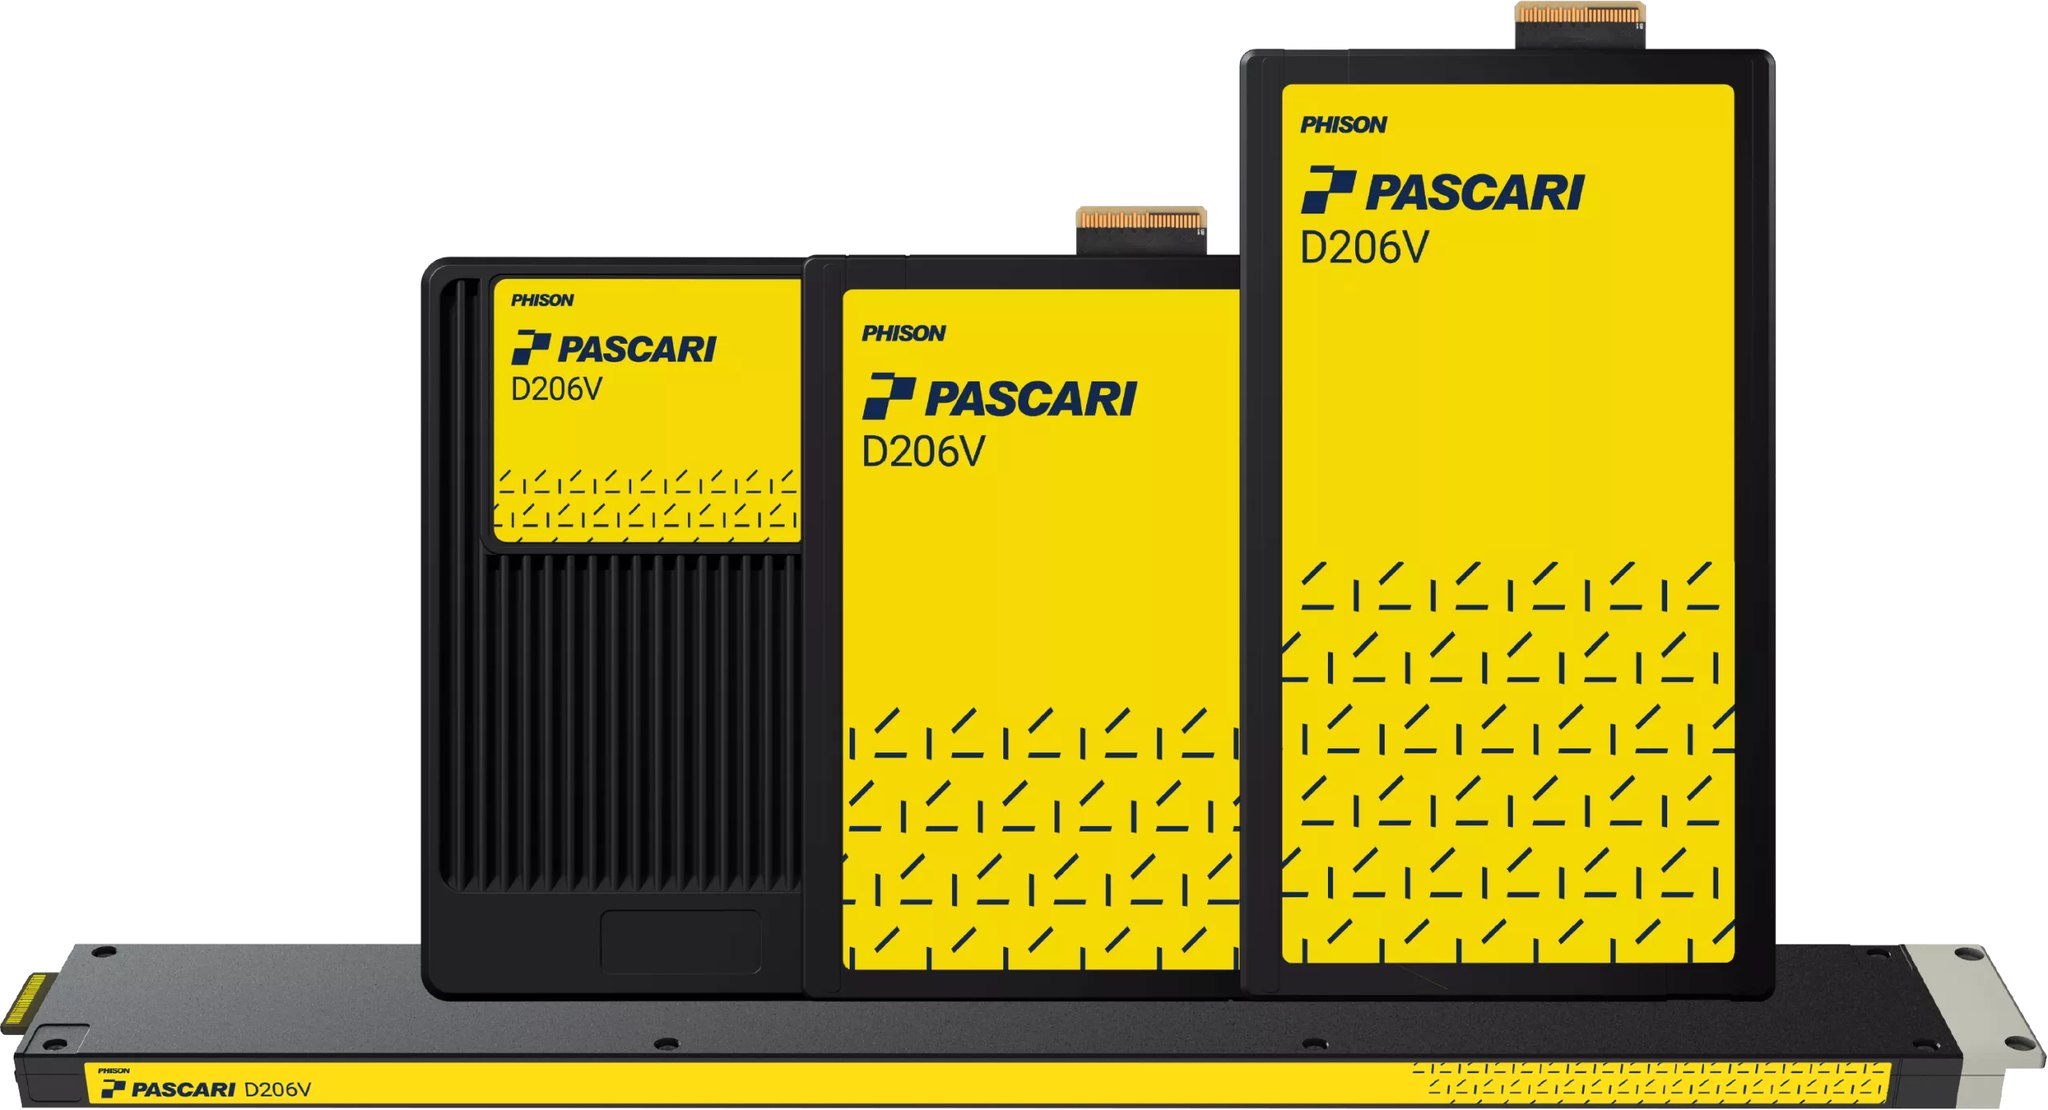
另一個比較特別的地方是,群聯以 DMIPS 而非 TOPS 來衡量 NPU 效能,而 TOPS 是多數 NPU 廠商慣用的單位。由於計算方式與慣例不同,讀者目前無法把這顆 NPU 與電腦或手機晶片上的 NPU 放在一起比較。
混合媒體設計與其他展出樣品
同樣在 SC26,群聯還帶來一款混合媒體(mixed media)設計,透過把高耐用度的 pSLC 快閃記憶體與 QLC 快閃記憶體放在同一顆 16 通道控制器之後,省去專用的快取硬碟。這種做法在硬碟故障時更有優勢:在配置 24 顆硬碟的伺服器中,損失一顆硬碟只會損失約 4% 的快取容量,傳統配置則高達 25%。展位上還有曾在 Computex 首度亮相的 PCIe Gen 6 控制器。
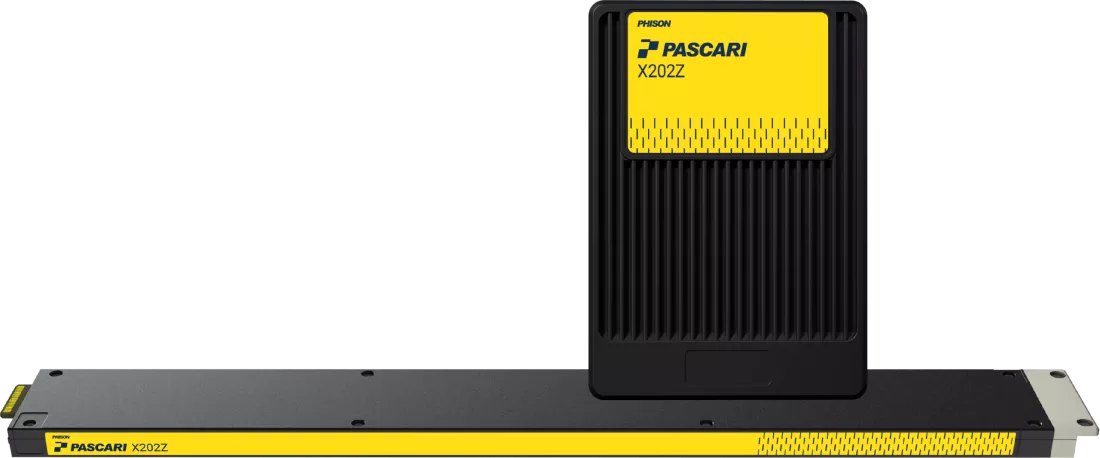
至於這款內建 NPU 的 SSD,目前公開的資訊相當有限。官方尚未說明使用哪一款控制器、採用什麼介面規格、尺寸為何,或是搭配哪種記憶體,這些規格也可能還在評估中。由於相關產品都仍在開發階段,最好將它們視為概念展示的樣品,而不是即將上市的產品。
群聯的方向有其道理:許多 AI 系統的瓶頸在於資料搬移,而不只是運算能力,所以讓硬碟先篩選資料再傳出去,是相當容易理解的減負做法。不過,減少 10 至 100 倍是官方針對合適工作負載給出的數字,而 NPU 規格又以 DMIPS 計算,因此很難獨立驗證。對越南使用者而言,這項產品主要面向資料中心與企業,短期內與個人電腦無關,等群聯公布完整規格與實測結果後再評估也不遲。
來源:TechPowerUp
審核人: Hero Association