Frostbite 的每瓦效能是 in-order 核心的 4.59 倍,但這只是 7 nm 的模擬結果,尚未製成實體晶片。
- Architect Labs 表示,旗下 AI 自行探索、設計並驗證了 Frostbite CPU,其指令集是全新的
- 4 tile 叢集的每瓦效能是對照用 in-order 核心的 4.59 倍;若只計算未經 AI 調校的 15 項任務,則為 3.83 倍
- 數據來自尚未投產的 7 nm 模擬,對照核心也未公開名稱
- 目前沒有與 out-of-order CPU 的比較,該公司預告將在未來幾個月內公布 SPEC 與 PARSEC 的結果
文章目錄
Frostbite 是什麼?與一般 CPU 有何不同
位於帕羅奧圖的新創公司 Architect Labs 表示,其 AI 系統自行探索、設計並驗證了 Frostbite。這是一款通用 CPU,採用從底層重新打造的全新指令集。在 25 項任務中,Frostbite 的 4 tile 叢集每瓦效能是某顆雙發射(dual-issue)、in-order、尺寸相當且已在矽晶片上驗證過的 CPU 核心的 4.59 倍。這個數字需要搭配幾項前提來看:它來自僅完成模擬的 7 nm 新設計,對照核心基於法律因素未公開名稱,而且只計算 15 項未經 AI 調校的任務時,領先幅度降為 3.83 倍。
Architect Labs 指出,傳統 CPU 必須靠硬體在執行當下「重新發現」哪些指令依賴哪些指令。多核心設計則需要多層快取與 coherence 協定,才能讓所有核心看到同一份共用記憶體,但這種做法難以擴充,同時耗費晶片面積與電力。他們選擇的方向是所謂的「multithreading for free」:由程式本身揭露可以平行執行的部分,因此不需要 thread、lock,也不必靠 out-of-order 硬體去找出這些工作。
Interaction net 與晶片的平行運算方式
Frostbite 的程式會被編譯成 interaction net。這是 1990 年就已提出的運算模型,程式是一張由節點組成的圖,運算則是逐對改寫彼此相連的節點。由於正在改寫的節點對不會互相重疊,不管依什麼順序執行或同時執行,結果都相同;每個值也只會被使用一次,所以資料可以放在小型的區域記憶體,不必使用大型共用快取。開發團隊舉的例子是在 5 x 5 棋盤上放置五個皇后、讓彼此都無法攻擊對方的問題:以 interaction net 執行時,求解過程拆成 3183 個小運算,必須依序執行的最長鏈只有 262 步,也就是每一步平均約有 12 個運算可同時進行,且無須修改程式。
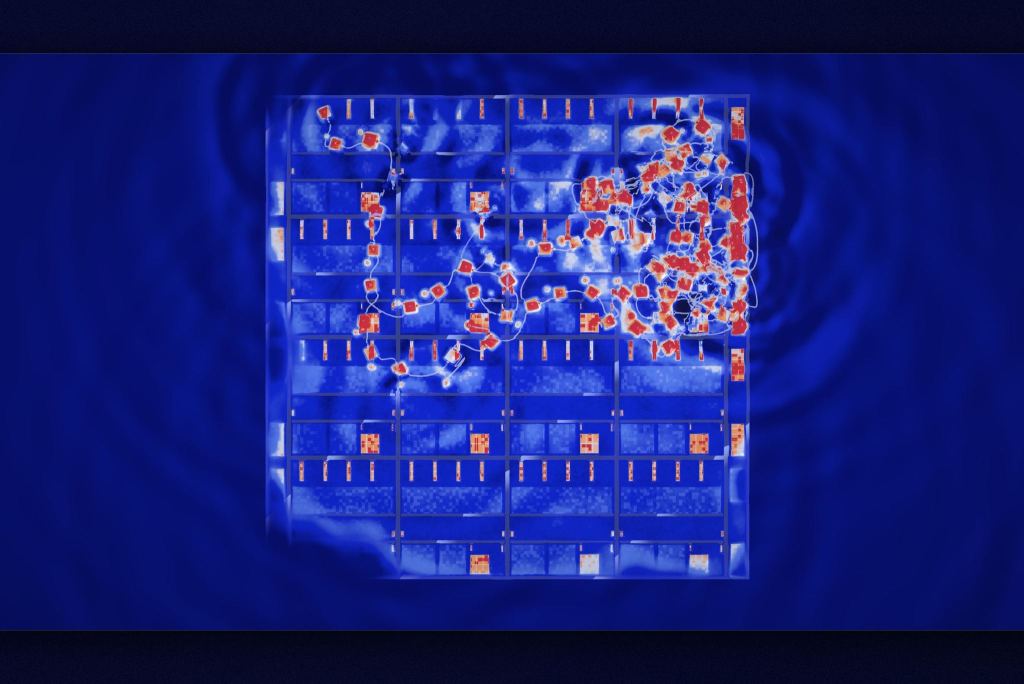
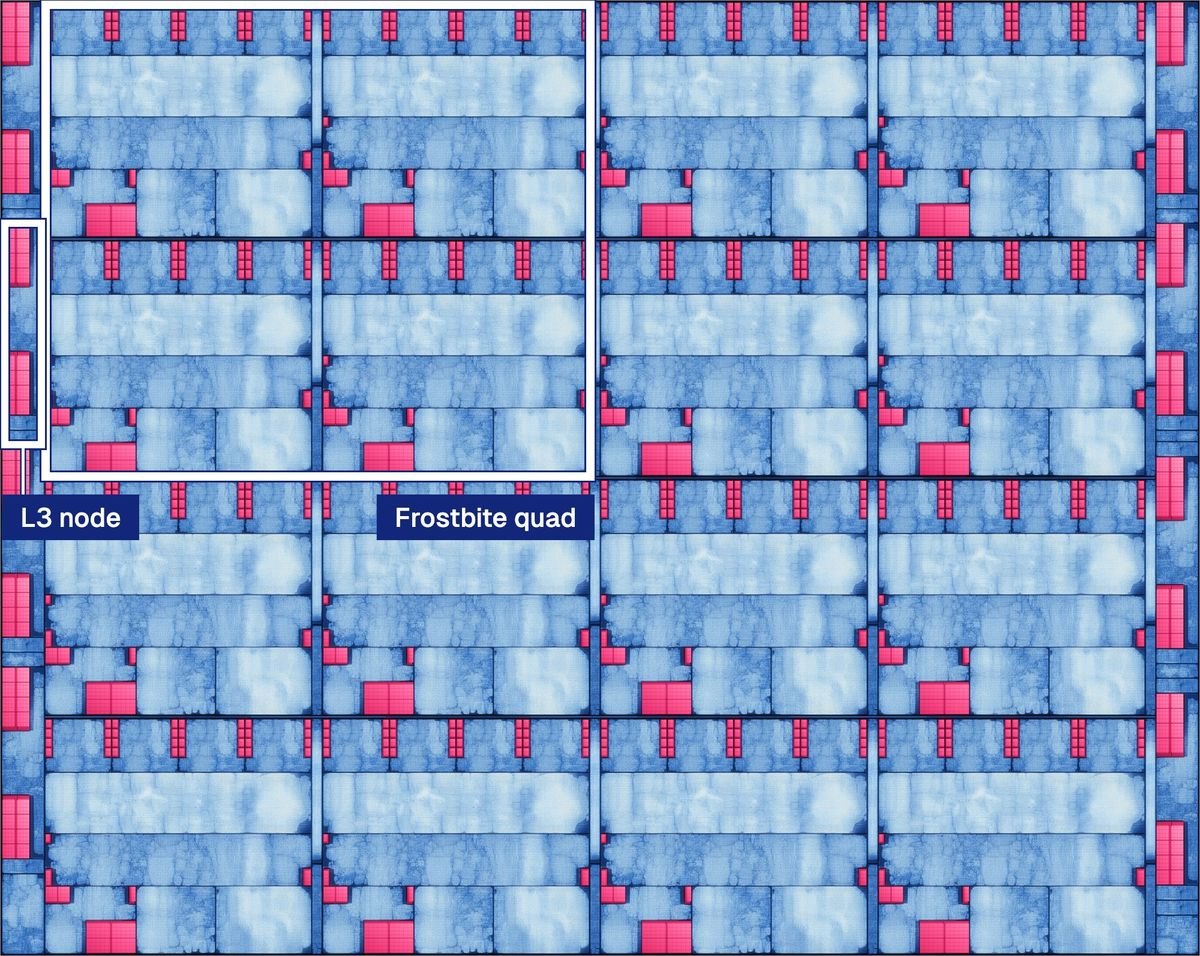
硬體方面,每個 tile 都是完全相同的小型處理單元,tile 之間透過晶片上的網路相連,並各自擁有區域記憶體。用於量測效能的叢集包含四個 tile 與四個 L3 節點,而晶片的完整配置圖則有 16 個 tile。這項設計在最初的合成階段曾達到 800 MHz,但最終 layout 定案為 500 MHz;若以面積計算,該叢集的平均效能是對照核心的 8.77 倍。
AI 如何設計這顆晶片
Architect Labs 表示,AI 是從「zero architectural priors」的狀態出發,也就是不帶任何既有的架構成見,不過團隊事先選定了晶片必須做好的任務。agent 會閱讀論文與 benchmark,用 Python 建立模型,再挑選一個要深入發展的構想。第一份長達 141 頁的 PDF 包含程式設計模型、runtime 與高階區塊,但在第一版暫存器傳輸層級(RTL)設計出爐後就被刪除,因為其中許多數字與估算與物理極限相差甚遠。
確定架構之後,agent 放棄了英文,因為團隊認為英文無法精確表達每個細節,也抓不出所有錯誤。他們改用公司自行開發的語言 ASL 撰寫規格。ASL 會被轉譯成證明工具 Lean,讓機器能檢查規格;該公司認為這能擋下一大類錯誤,同時限制 agent 鑽漏洞、規避所設定的目標。接著 agent 在尚未有任何電路設計之前,先用 ASL 建出整顆晶片的軟體模型 Arcmodel。這個模型比 RTL 模擬快約 200 倍,初期的電力估算雖然誤差高達近 250%,但經由自動化迴圈反覆調整,最終與電路設計的差距縮小到 5% 以內。
後續由多組 agent 同時提出修改,每項修改都要對照規格、在快速模型上測試、套入電路設計並量測耗電,才決定保留或捨棄。結果共測試了 58 個構想,其中 37 個被保留。過程中還出現一種該公司稱從未由人類指定的行為,名為 work stealing:做完工作的 tile 會從相鄰 tile 分走多餘的工作;若沒有工作可分,就進入休眠狀態以節省電力。
Architect Labs 的下一步
這不是 Architect Labs 的第一個設計。今年 8 月,該公司曾發表 Redwood,一款用於機器人與無人機的 AI 推論加速器。該公司表示,Redwood 的 RTL、驗證、韌體、driver 與 kernel,是由 AI 根據兩位人類架構師撰寫的規格,在不到兩週內產出。Redwood 目前仍只在 FPGA 上執行,尚未製成實體晶片,不過該公司表示正在尋求由台積電(TSMC)生產的方式。另一方面,位於英國劍橋的 Tendrils Compute 最近為一款處理器募資,他們表示該處理器將具備數千個平行運作的核心,同時也在開發 Vine,也就是用來撰寫 Frostbite 程式的語言。
Architect Labs 表示還會公布更多 benchmark,但這只是計畫的一部分。該公司希望打造一個在 FPGA 上執行的軟體試驗場,讓任何人都能嘗試在 Frostbite 上跑程式,並搭配初階的作業系統,長期則會釋出晶片的 RTL 與指令集。接下來,公司打算擴大任務數量,並與更多類型的 CPU 比較,包括把規模更大的 Frostbite mesh 配置,拿來對照具備大型快取的多核心版對照核心,同時也會測試更大、更寬的 out-of-order CPU,預計在未來幾個月內公布 SPEC 與 PARSEC 等常見 benchmark 的結果。
Migovi 認為,這個構想值得關注之處在於 Frostbite 採用了完全不同的運算模型,而不是在舊架構上繼續微調,但目前已公開的數據還不足以判斷真實效能。晶片只完成模擬,對照核心是未具名的 in-order 核心,而且扣除經 AI 調校的任務後,領先幅度就從 4.59 倍降到 3.83 倍,顯示部分優勢來自測試題目的選擇。更具說服力的比較,是與 out-of-order CPU 及具備大型快取的多核心處理器對照,也就是該公司承諾要在 SPEC 與 PARSEC 上公布的結果。對越南使用者而言,這還不是值得購買或提早期待的產品,較合理的做法是等到這些結果與公開的 RTL 出爐後,再決定要不要相信 4.59 倍這個數字。
審核人: Hero Association